Semaine 1 : Installer et maîtriser le socle › Semaine 1 : Partie 1 (Comprendre le système) › Carte du système
# Sécurité, confidentialité et secrets
Dans un cadre professionnel, utiliser l’IA peut impliquer des données soumises au RGPD, à l’AI Act ou à des engagements de confidentialité.\
Notre point de départ est un environnement que nous maîtrisons : les fichiers restent en local ou sur nos propres serveurs.\
C’est un avantage important, mais certaines données peuvent encore être transmises aux modèles ou aux outils connectés. Ce cours t’aide à repérer ces flux et à choisir les protections adaptées à tes usages professionnels.
Travailler avec l’IA dans tes fichiers locaux, ça soulève deux questions : qu’est-ce qu’elle peut faire sur ton ordinateur, et qu’est-ce qui sort vers le provider quand tu lui parles. Cette leçon répond aux deux, dans cet ordre.
<div class="privacy-overview border-gradient not-prose" aria-label="Les deux dimensions de la sécurité">
<div><span class="privacy-overview__number">01 / ACTIONS</span><h2>Ce que l’IA peut faire.</h2><p>Les permissions définissent son périmètre d’action sur ton ordinateur.</p><a href="#1-lia-na-pas-accès-à-tout-par-défaut">Garder le contrôle <span aria-hidden="true">↗</span></a></div>
<div><span class="privacy-overview__number">02 / DONNÉES</span><h2>Ce qui sort de chez toi.</h2><p>Le contexte envoyé, les providers, la rétention et les secrets.</p><a href="#2-ce-qui-est-envoyé-au-modèle-et-ce-qui-ne-lest-pas">Comprendre les flux <span aria-hidden="true">↗</span></a></div>
</div>
## 1. L'IA n'a pas accès à tout par défaut
C'est le premier point à comprendre. Quand tu lances OpenCode Desktop, **l'IA ne peut rien faire sans ta validation**. Elle a la configuration de base d'OpenCode, qui te demande explicitement avant chaque action :
- Lire ce fichier : tu valides ?
- Modifier cette note : tu valides ?
- Exécuter cette commande bash : tu valides ?
C'est volontaire. Tu gardes le contrôle de tout, mais ça peut vite devenir lourd au quotidien.
<div class="diagram-cards not-prose">
<div class="diagram-card diagram-card--violet"><p class="eyebrow">Mode strict</p><p class="diagram-card-title">Validation au cas par cas</p><p class="diagram-card-body">L'IA demande la permission avant chaque action. Maximum de sécurité, friction quotidienne forte.</p></div>
<div class="diagram-card diagram-card--blue"><p class="eyebrow">Mode équilibré</p><p class="diagram-card-title">Permissions ciblées</p><p class="diagram-card-body">Tu autorises les actions sûres (lecture, écriture dans ton coffre), tu bloques les risquées (rm, curl). Équilibre fluide.</p></div>
<div class="diagram-card diagram-card--orange"><p class="eyebrow">Mode auto</p><p class="diagram-card-title">Auto-accept tout</p><p class="diagram-card-body">L'IA peut tout faire sans demander. Fluide pour le travail intensif, à éviter sur projets clients sensibles.</p></div>
</div>
### Le bouton « accepter automatiquement »
Dans les réglages d'OpenCode Desktop, tu peux activer une option qui dit à l'IA : « tu peux faire ce que tu veux sans me demander, je te fais confiance ». Pratique quand tu travailles à fond. Tu peux la désactiver à tout moment.
> **Compromis classique :** confiance maximale (fluide mais l'IA peut tout faire) vs validation au cas par cas (sécurisé mais lent). La plupart des participants finissent par activer l'auto-accept dans leur coffre, et désactivent quand ils travaillent sur des projets clients sensibles.
### Restreindre finement les permissions
Si tu veux quelque chose entre les deux extrêmes (auto-accept ou validation totale), tu peux configurer **précisément** ce que l'IA peut faire dans le fichier `opencode.json` à la racine de ton workspace.
C'est du JSON. Tu peux l'écrire toi-même en lisant la [documentation officielle d'OpenCode sur les permissions](https://opencode.ai/docs/permissions). Ou, mieux : tu demandes à l'IA de le faire pour toi.
### Le mini-prompt pour configurer tes permissions sans toucher au JSON
Plutôt que d'apprendre la syntaxe `opencode.json`, copie-colle ce prompt à ton IA dans OpenCode :
**Prompt à coller dans OpenCode**
```text
Je veux configurer tes permissions dans opencode.json.

D'abord, lis la documentation officielle ici :
https://opencode.ai/docs/permissions

Ensuite, pose-moi ces questions une par une, attends ma réponse
(oui / non / précise) avant de passer à la suivante :

1. Tu peux lire les fichiers dans Business Brain/ sans me demander ?
2. Tu peux écrire dans Business Brain/ sans me demander ?
3. Tu peux accéder aux autres dossiers de mon Workspace ?
4. Tu peux exécuter des commandes shell (git, ls, cat) sans me demander ?
   Ce sont des instructions données à l'ordinateur via le terminal :
   par exemple, lister des fichiers, lire leur contenu ou gérer l'historique
   des modifications. Certaines commandes git peuvent aussi modifier
   des fichiers ou envoyer des données en ligne.
5. Tu peux exécuter des commandes réseau (curl, wget) sans me demander ?
   Elles permettent de contacter des sites ou des services en ligne,
   de télécharger des fichiers ou d'envoyer des données hors de ton ordinateur.
6. Tu peux exécuter des commandes destructrices (rm, mv, rmdir) sans me demander ?
   Elles permettent de supprimer des fichiers ou des dossiers, ou de les
   déplacer et renommer. Un déplacement peut aussi remplacer un fichier
   existant ; une suppression peut être définitive, sans passer par la corbeille.

À la fin, mets à jour opencode.json avec mes choix, montre-moi le résultat,
et explique-moi en une phrase ce que ça change.
```
L'IA va lire la doc à jour, te poser les questions dans ton langage, et écrire le JSON pour toi. Tu valides à la fin. Tu n'as jamais à toucher au JSON manuellement.
## 2. Ce qui est envoyé au modèle (et ce qui ne l'est pas)
C'est le deuxième point essentiel : **quand tu poses une question à ton IA, qu'est-ce qui sort de ton ordinateur exactement ?**
La réponse va te rassurer.
### Ton coffre n'est pas uploadé en bloc
À chaque requête, l'IA ne « charge » pas tout ton coffre en mémoire pour ensuite l'envoyer au provider. Voici ce qui se passe vraiment :
<div class="system-comparison not-prose">
<div class="system-comparison__panel system-comparison__panel--green">
<p class="system-comparison__title">Sur ton ordinateur</p>
<p class="diagram-card-title">Tout ton coffre reste local</p>
<ol class="system-comparison__list"><li>L'IA scanne les noms de fichiers et la structure</li><li>Elle identifie les fichiers pertinents pour ta question</li><li>Elle lit uniquement ceux-là (3, 5, parfois 20 fichiers)</li><li>Elle écrit les modifications directement sur ton disque</li></ol>
</div>
<div class="system-comparison__panel system-comparison__panel--blue">
<p class="system-comparison__title">Envoyé au provider IA</p>
<p class="diagram-card-title">Uniquement des extraits</p>
<ol class="system-comparison__list"><li>Ta question (le prompt)</li><li>Le contenu des fichiers que l'IA a lus</li><li>L'historique de la conversation en cours</li><li>Rien d'autre. Pas de scan global, pas d'upload du coffre</li></ol>
</div>
</div>
> **Image mentale :** l'IA ouvre 3 onglets de notes dans Obsidian, lit ces 3 notes, et c'est tout ce qui sort. Le reste du coffre reste invisible pour le provider.
### Conséquence pratique
Tu **n'as pas besoin de deux coffres séparés** (un « sécurisé » et un « pas sécurisé »). L'IA ne va lire que ce dont elle a besoin pour la requête en cours.
Et tu peux utiliser **différents modèles selon la sensibilité** de chaque tâche, dans le même coffre. Par exemple :
- Tâche de brainstorm: DeepSeek V4 Flash sur OpenRouter ZDR
- Tâche avec données clients : GLM 5.3 via Synthetic AI (abonnement ZDR)
- Tâche créative sans enjeu : ChatGPT (GPT 5.6)
Tu bascules dans OpenCode Desktop en une seconde. Le coffre reste le même.
## 3. Pourquoi la confidentialité, c'est important
Les points clés en 1 minute :
- **Snowden, 2013** : les agences de renseignement américaines (NSA Prism, programme XKeyscore) ont un accès direct aux serveurs de Google, Facebook, Apple, Microsoft. La devise interne : « on enregistre tout, on filtrera plus tard si besoin ». Le programme existe toujours, en plus puissant.
- **Cloud Act, 2018** : toute entreprise US (peu importe où sont les serveurs) doit livrer les données au gouvernement américain sur demande. Donc même un data center « européen » d'AWS ou Azure est concerné.
- **Politiques de rétention en pratique** : ChatGPT conserve par défaut tant que ton compte existe. Claude conserve 5 ans + 30 jours après suppression + jusqu'à 2 ans pour modération « trust & safety » humaine. La suppression vraiment effective est rarement immédiate.
- **Le marché de la prédiction** : ton profil comportemental vaut de l'argent. C'est ce que documente Shoshana Zuboff dans *The Age of Surveillance Capitalism*. Cambridge Analytica, Brexit, élection Trump sont les exemples emblématiques.
<div class="practical-consequence not-prose">
<p class="practical-consequence__kicker">La posture saine</p>
<p class="practical-consequence__body">Considérer que tout ce qui sort vers un provider US est potentiellement archivé pour toujours, peu importe ce que dit leur politique de confidentialité officielle.</p>
</div>
### Qu'est-ce qui est en jeu pour ton entreprise ?
Un document professionnel traité par une IA engage rarement ton seul périmètre. Il peut contenir des informations sur ton entreprise, tes clients, tes collaborateurs ou tes partenaires. La confidentialité couvre alors l'ensemble de ces enjeux : **la conformité réglementaire, la protection de tes secrets d'affaires et de ta stratégie, le respect de tes engagements contractuels, et ta capacité à démontrer la sécurisation et l'usage des données de tiers.**
**1. Tes secrets d'affaires et ton avantage concurrentiel**
Tes marges, tes méthodes internes, ton fichier clients, ton code source ou ta stratégie de développement peuvent représenter des années de travail. Certaines de ces informations ont de la valeur précisément parce que tes concurrents n'y ont pas accès.
**Exemple :** tu demandes à une IA de revoir ta stratégie commerciale en lui donnant tes prix d'achat, tes marges et les conditions négociées avec tes fournisseurs. Tu confies alors une partie de ton savoir-faire commercial à un prestataire extérieur.
En Belgique comme en France, la protection des secrets d'affaires repose sur un cadre européen commun. Elle suppose notamment de prendre des **mesures raisonnables pour préserver leur confidentialité**. Le choix des outils d'IA et les conditions dans lesquelles tu leur transmets des données font partie de cette réflexion. ([SPF Économie](https://economie.fgov.be/fr/themes/propriete-intellectuelle/droits-de-propriete/regimes-de-protection/secrets-daffaires-protection))
**2. Les engagements pris envers tes clients et partenaires**
Un client peut t'autoriser à consulter ses documents pour réaliser une mission, sans t'autoriser à les transmettre à n'importe quel service externe.
**Exemple :** tu reçois le business plan confidentiel d'un client et tu le donnes à une IA pour préparer une synthèse. Selon l'accord de confidentialité ou le contrat de prestation, cette transmission peut nécessiter une autorisation ou des garanties particulières.
Le sujet n'est donc pas seulement : « Est-ce que mes données vont fuiter ? » Il est aussi : **« Est-ce que mes engagements me permettent de les confier à ce fournisseur ? »** Le SPF Économie identifie d'ailleurs les accords de confidentialité avec les partenaires commerciaux comme une mesure de protection des secrets d'affaires. ([SPF Économie](https://economie.fgov.be/fr/themes/propriete-intellectuelle/droits-de-propriete/regimes-de-protection/secrets-daffaires-protection))
**3. Les données personnelles de tes collaborateurs et de tes clients**
Un CV, une fiche de paie, une évaluation annuelle ou un historique de réclamations contient des informations sur des personnes. Leur traitement par une IA reste soumis au **RGPD**, applicable à travers toute l'Europe.
**Exemple :** tu demandes à une IA de comparer plusieurs candidats en lui transmettant leurs CV et tes notes d'entretien. Tu fais traiter des données personnelles par un service supplémentaire.
Il faut notamment définir l'usage, limiter les données transmises au nécessaire et vérifier les conditions de traitement du fournisseur. **Désactiver l'entraînement sur tes données ne suffit pas, à lui seul, à rendre cet usage conforme.** L'Autorité de protection des données belge rappelle que les utilisateurs et exploitants de systèmes d'IA doivent respecter les principes de protection des données personnelles. ([APD belge](https://www.autoriteprotectiondonnees.be/citoyen/themes/intelligence-artificielle-))
**4. Tes dossiers juridiques et ta stratégie de défense**
Un projet de contrat, un dossier de litige ou des échanges avec ton avocat peuvent contenir des informations particulièrement confidentielles.
**Exemple :** tu demandes à une IA de t'aider à préparer une négociation en lui transmettant les faiblesses de ton dossier et le montant maximal que tu accepterais de payer. Ces informations révèlent directement ta stratégie.
Selon la nature des documents, la profession concernée et le droit applicable, des obligations de confidentialité ou de secret professionnel peuvent s'ajouter. Il faut donc vérifier avec le conseil concerné quels documents peuvent être utilisés et dans quel environnement.
**5. Tes négociations et tes projets stratégiques**
Certaines informations sont sensibles parce qu'elles arrivent au mauvais moment entre les mauvaises mains : projet d'acquisition, levée de fonds, réponse à un appel d'offres, lancement d'un produit ou négociation fournisseur.
**Exemple :** tu demandes à une IA de préparer une offre à partir d'un document qui contient ton prix plancher, ton budget maximal et les concessions possibles. Si ces informations deviennent accessibles à l'autre partie, ta position de négociation peut être affaiblie.
Le risque à maîtriser est celui d'une divulgation ou d'un accès non prévu. Il n'est pas nécessaire de supposer qu'un fournisseur revendrait volontairement tes informations pour justifier leur protection.
**6. La protection des données de tiers et la preuve de conformité**
Quand tu traites des données pour le compte d'une organisation — client, partenaire ou donneur d'ordre — tu deviens responsable de leur usage et de leur sécurisation. Le RGPD ne demande pas seulement de respecter ces obligations : il demande de pouvoir le **démontrer**.
**Exemple :** un client te demande où sont traitées les données de ses clients, combien de temps elles sont conservées et qui peut y accéder. Sans documentation, tu ne peux pas répondre.
Pour chaque outil d'IA utilisé sur des données de tiers, tu dois pouvoir préciser : quelles données sont transmises, à quel prestataire, pour quelle finalité, combien de temps elles sont conservées, qui peut y accéder et selon quelles garanties contractuelles (accord de sous-traitance, clauses de confidentialité, localisation du traitement). Cette traçabilité relève directement du principe de responsabilité du RGPD. ([APD belge](https://www.autoriteprotectiondonnees.be/publications/brochure-d-information-sur-les-systemes-d-intelligence-artificielle-et-le-rgpd.pdf))
**La posture à adopter**
Avant de transmettre un document à une IA, pose-toi trois questions :
1. **Qu'est-ce que ce document révèle ?** Des informations publiques, des données personnelles, du savoir-faire ou une stratégie confidentielle ?
2. **Ai-je le droit de le partager avec ce prestataire ?** Au regard de mes contrats, de mes obligations et des règles de mon entreprise.
3. **Quelles garanties couvrent réellement cet usage ?** Accès, conservation, réutilisation, sous-traitants et localisation du traitement.
**L'objectif est de choisir le bon outil et le bon niveau de protection pour chaque tâche, afin de profiter de l'IA tout en protégeant ton entreprise.**
## 4. La confidentialité au quotidien : deux options ZDR
C'est la recommandation par défaut pour 90 % des cas.
**ZDR (Zero Data Retention)** signifie que ta requête arrive au provider, le modèle génère une réponse, et **tout est supprimé immédiatement**. Rien stocké, rien loggué, rien réutilisé pour entraîner un modèle. Le provider s'engage contractuellement et c'est auditable.
Pour ton usage professionnel, tu as deux options ZDR complémentaires. On **met en avant Synthetic AI** (abonnement professionnel) pour tout ce qui touche des données clients ou sensibles, et on garde **OpenRouter ZDR** (au token) pour un usage non intensif ou un large choix de modèles.
### Option 1 (à privilégier pour le professionnel) : Synthetic AI
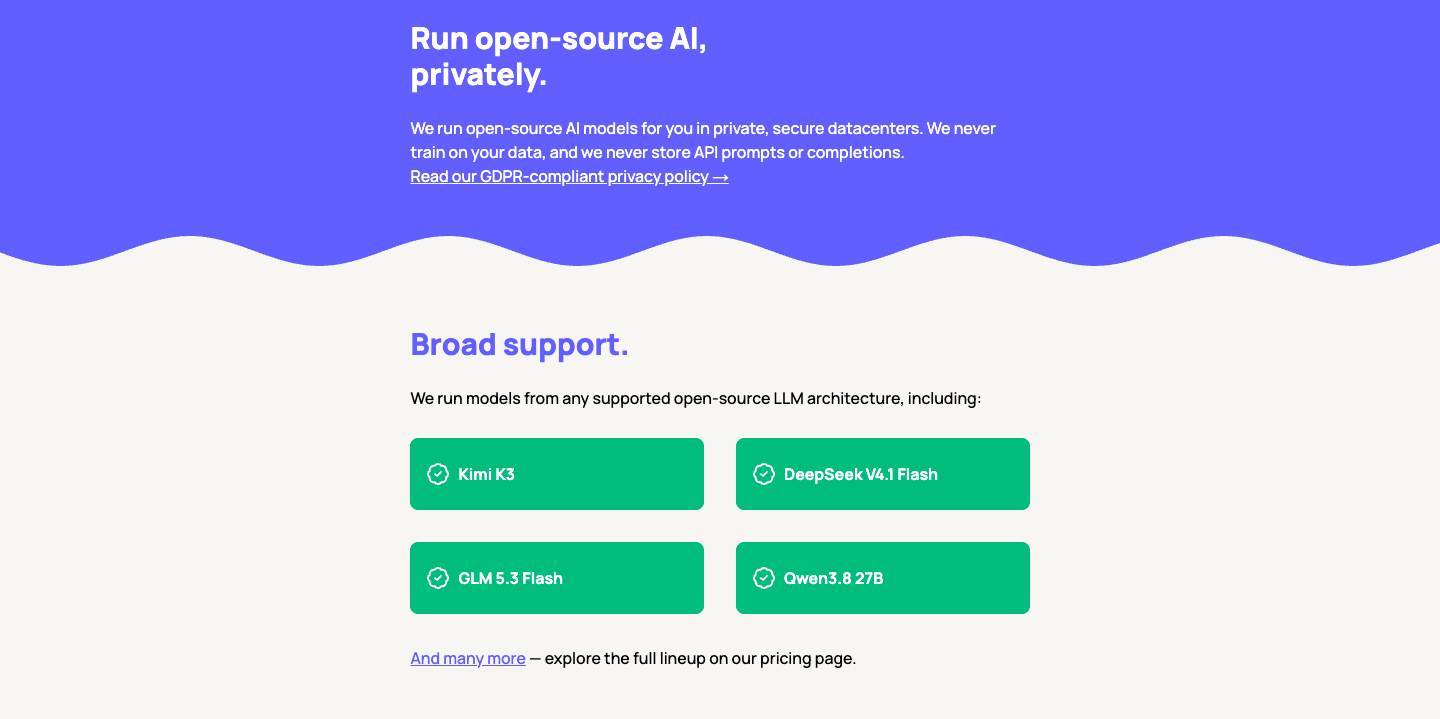
<img class="lesson-figure" src="/images/synthetic-ai-landing.png" alt="Synthetic AI, Run open-source AI privately et la liste des modèles supportés." />
**Synthetic AI** est un **abonnement à 30 $/mois** (pas de paiement au token) qui te donne des tokens **ZDR (zéro rétention)**, servis très rapidement. C'est notre recommandation pour tout ce qui est sensible : données clients, raisonnement sur des sujets sensibles, tâches complexes. Tu prends l'abonnement, tu le connectes dans OpenCode, et tout passe en ZDR sans jamais réfléchir au coût par requête.
[synthetic.new](https://synthetic.new/?referral=jhBi88o8juvemeR)
### Option 2 : OpenRouter ZDR, au token
**OpenRouter** permet d'accéder à l'ensemble des LLM en ZDR et de facturer au token. C'est parfait pour une utilisation non intensive de l'IA et pour avoir accès à un maximum de LLM.
<img class="lesson-figure" src="/images/openrouter-landing.png" alt="OpenRouter, The Unified Interface For LLMs, et plus de 400 modèles." />
[openrouter.ai](https://openrouter.ai) : 400+ modèles, 60+ providers, une seule API.
1. Connecte-toi sur [openrouter.ai](https://openrouter.ai) *(pas besoin de le faire maintenant : cette étape est couverte dans la partie « Installer ton Core System »)*
2. Va dans **Settings** (en haut à droite)
3. Section **Privacy** : active **Zero Data Retention**
4. **Save**
OpenRouter ne route alors que vers des providers qui ont signé l'engagement ZDR (Fireworks, Parasail, certaines instances DeepInfra...). Tes requêtes ne sont plus stockées.
<div class="diagram-cards">
<div class="diagram-card diagram-card--green"><p class="eyebrow">Routes ZDR</p><p class="diagram-card-title">Synthetic AI / OpenRouter</p><ul><li>Entraînement sur tes données : non</li><li>Stockage de tes conversations : non</li><li>Accès humain à tes échanges : non</li><li>Idéal pour : usage non intensif, large choix de modèles</li></ul></div>
<div class="diagram-card diagram-card--rose"><p class="eyebrow">À éviter pour le sensible</p><p class="diagram-card-title">Abonnements ChatGPT Plus et Claude Pro</p><ul><li>Entraînement : oui par défaut, opt-out manuel</li><li>Stockage : tant que le compte existe</li><li>Accès humain : possible (modération abus)</li><li>Rétention minimum : 30 jours après suppression</li></ul></div>
</div>
### Sur ChatGPT, désactive l'entraînement
Si tu utilises ChatGPT Plus connecté à OpenCode Desktop, fais ce réglage manuellement :
1. Va sur [chatgpt.com](https://chatgpt.com), clique sur ton avatar en haut à droite *(pas besoin de le faire maintenant : cette étape est couverte dans la partie « Installer ton Core System »)*
2. **Settings**, puis **Data Controls**
3. Désactive **« Improve the model for everyone »**
OpenAI ne peut plus utiliser tes conversations pour entraîner ses modèles. Note : la rétention reste tant que ton compte existe, ce n'est pas du ZDR. Pour les tâches sensibles, préfère Synthetic AI (GLM 5.3) ou OpenRouter ZDR.
## 5. Si tu préfères héberger en Europe
Pour ceux qui veulent une infrastructure non-US par principe (souveraineté, RGPD strict, Cloud Act), voici les options réelles à l'été 2026.
### Recommandation : Scaleway Generative APIs
[Scaleway](https://www.scaleway.com/en/generative-apis/) est la meilleure option européenne pure-play. Data centers en France, ZDR par défaut (pas besoin d'activer une option), pas d'entraînement sur tes données, RGPD natif. Ils proposent Llama 3, Mistral, Mixtral, DeepSeek R1. Pas dépendant d'AWS / Azure / GCP : infrastructure propre.
<img class="lesson-figure" src="/images/scaleway-landing.png" alt="Page produit Scaleway Generative APIs." />
### Alternative équivalente : OVHcloud AI Endpoints
[OVHcloud AI Endpoints](https://www.ovhcloud.com/en/public-cloud/ai-endpoints/), data centers à Gravelines, plus de 40 modèles open source, certifié ISO 27001/27017/27018/27701. Souveraineté française complète, infrastructure 100 % propre.
<img class="lesson-figure" src="/images/ovhcloud-landing.png" alt="Page produit OVHcloud AI Endpoints." />
## 6. Pour les données très sensibles : faire tourner le modèle en local
Si tu travailles avec des données de santé, juridiques, hautement confidentielles, ou si tu veux la souveraineté absolue, **fais tourner le modèle sur ton propre matériel**. Rien ne sort de ton réseau.
La règle de base : pour que ça soit utilisable, le modèle doit tenir **entièrement dans ta RAM** (sur Mac, c'est de la RAM unifiée partagée avec le GPU). S'il déborde sur le disque, la vitesse s'effondre. Ton plafond de RAM détermine donc directement les modèles auxquels tu as accès.
<div class="diagram-cards">
<div class="diagram-card diagram-card--green"><p class="eyebrow">Le plus simple (CLI)</p><p class="diagram-card-title">Ollama</p><p class="diagram-card-body">Une commande pour tout installer (<code>curl -fsSL ollama.com/install.sh | sh</code>), puis <code>ollama run qwen3:8b</code>. Idéal pour OpenCode Desktop qui s'y connecte en un clic.</p><p><a href="https://ollama.com">ollama.com ↗</a></p></div>
<div class="diagram-card diagram-card--blue"><p class="eyebrow">Interface graphique</p><p class="diagram-card-title">LM Studio</p><p class="diagram-card-body">Une app desktop avec catalogue de modèles, téléchargement en un clic, chat intégré, et un serveur local compatible OpenAI. Plus accessible si tu fuis le terminal.</p><p><a href="https://lmstudio.ai">lmstudio.ai ↗</a></p></div>
</div>
### Tier 1 : 16 Go de RAM (MacBook Air M2, MacBook Pro M3 base)
<div class="ram-tier"><p><strong>16 Go</strong> · Découvrir le local · Modèles de 3 à 8B</p></div>
Tu peux faire tourner des modèles de 3 à 8 milliards de paramètres en Q4 (quantisation 4 bits). C'est suffisant pour du chat, de l'aide à la rédaction, des recherches simples. **Pas suffisant pour de l'agentique avancé** (multi-step, tool calls complexes).
Modèles à essayer :
- **Gemma 4 E2B** (Google, ~3,5 Go en Q4). C'est le nouveau modèle Google sorti en avril 2026. Multimodal (texte + audio + image). DeepMind a annoncé en mai un projet « Accelerating Gemma 4 » qui ajoute du **multi-token prediction** (le modèle prédit plusieurs tokens à la fois, ce qui accélère l'inférence sans dégrader la qualité). À surveiller.
- **Qwen 3 4B** ou **Qwen 3 8B** : très bon rapport qualité/taille, contexte 256K.
- **Llama 3.2 3B** : rapide, qualité correcte pour du chat.
Vitesse attendue : 30 à 60 tokens/seconde sur Mac M3 16 Go. Confortable pour du chat, juste pour de l'agentique.
L'intérêt à ce tier, c'est surtout de **comprendre comment le local fonctionne** et de tester. Pour un usage knowledge worker complet, tu seras vite limité.
### Tier 2 : 32 à 64 Go de RAM (MacBook Pro M3 Max, Mac mini M4 Pro)
<div class="ram-tier"><p><strong>32–64 Go</strong> · Travailler au quotidien · Modèles de 12 à 32B</p></div>
C'est le tier où le local devient vraiment utilisable au quotidien. Les modèles 12 à 32 milliards de paramètres deviennent confortables.
- **Gemma 4 26B-A4B** (Google, MoE, ~18 Go en Q4) : 3,8B de paramètres actifs seulement à chaque token, donc rapide.
- **Qwen 3 32B** (Q4) : meilleur open weight 30B à l'été 2026.
- **DeepSeek R1 32B** (Q4) : fort en raisonnement.
- **Mistral Small 24B** (Q4) : inférence très rapide.
Sur 64 Go, les modèles 70B (~43 Go en Q4) deviennent accessibles : Llama 3.3 70B, DeepSeek R1 70B.
### Tier 3 : 128 Go et plus (Mac Studio M3/M4 Ultra)
<div class="ram-tier"><p><strong>128 Go et +</strong> · Grands modèles · Infrastructure dédiée</p></div>
C'est ici que tu peux faire tourner les **gros modèles open source frontières** (GLM 5.3, DeepSeek V4 Flash, Qwen 3 235B). Ordre de prix :
- **Mac Studio M3 Ultra 192 Go** : 10 000 à 13 000 €
- **Mac Studio M4 Ultra 512 Go** : 25 000 à 30 000 € (haut de gamme grand public absolu)
À 192 Go, tu peux faire tourner :
- **DeepSeek R1 70B en Q8** (~80 Go) : qualité quasi équivalente à la version full precision
- **Qwen 3 235B MoE en Q2** (~90-100 Go) : 22B actifs à chaque token
- **GLM 5.3 744B MoE en Q2** (~150 Go estimé) : 40B actifs
- **Mistral Large 123B en Q4** (~75 Go)
À 512 Go, **DeepSeek V4 Flash en Q4** ou même certains modèles 400B+ deviennent faisables.
### Comprendre la quantisation (Q2, Q4, Q5...)
Un modèle « brut » stocke ses paramètres en 16 bits (FP16). Le quantiser, c'est compresser ces paramètres sur moins de bits, pour qu'il prenne moins de RAM.
| Niveau | Bits/poids | Effet sur la qualité | Quand l'utiliser |
|---|---|---|---|
| **Q5** | ~5 bits | Quasi identique au full precision | Si tu as la RAM |
| **Q4** | ~4 bits | Légère perte, peu perceptible | **Le défaut recommandé** |
| **Q2** | ~2 bits | Dégradation visible : hallucinations, raisonnement moins fiable | Uniquement pour les très gros modèles (100B+) quand tu n'as pas le choix pour tenir en RAM |
Le suffixe `K_M` ou `K_S` (K-quant Medium / Small) indique une variante optimisée qui préserve mieux les couches importantes du modèle. Pour Ollama, le défaut est généralement `Q4_K_M`, c'est très bien.
### Pour aller plus loin
Sur le hardware et l'optimisation du local, je te recommande la chaîne YouTube **[@xcreate](https://www.youtube.com/@xcreate)** qui couvre le sujet en profondeur : choix de hardware, quantisation, comparaisons de modèles, retours d'expérience sur les Mac Studio.
### Cas pratique : une équipe qui mutualise
Pour une société de 5 à 50 personnes, **un Mac Studio Full Spec partagé** devient rapidement rentable comparé à 10 ou 50 abonnements API. Tu installes Ollama dessus, tu exposes l'API en réseau local, chacun connecte son OpenCode Desktop dessus. Rien ne sort de l'infra. ROI typique : moins d'un an de mutualisation par rapport aux abonnements individuels.
## 7. Gérer ses secrets : API keys et mots de passe
La meilleure solution est d'utiliser un gestionnaire de mots de passe. Il centralise proprement tous tes secrets (clés API, mots de passe, tokens, clés SSH) et permet à ton IA de récupérer un secret à la volée dans tes scripts ou tes sessions, sans jamais l'exposer en local. Ton coffre reste protégé dans un environnement dédié.
Si tu étends ton intégration IA à tes équipes, il permet aussi de mutualiser certains accès et clés API, tout en gardant le niveau de contrôle requis.
Si tu en utilises déjà un, nous pourrons analyser sa compatibilité et l'intégrer dans ta stack. Si ce n'est pas encore le cas, nous préconisons 1Password.
### Pourquoi 1Password ?
<img class="lesson-figure" src="/images/1password-hero.png" alt="1Password, accès sécurisé pour chaque agent humain et agent IA." />
1Password conserve cette clé dans un coffre chiffré. Son Environment la transmet uniquement au processus qui en a besoin. La configuration OpenCode contient la commande et l'identifiant de l'Environment, jamais la valeur de la clé.
> **Installation :** [[00 - Cours - Gestionnaire de secrets et connexion sécurisée|Connecter 1Password]]. Tout y est expliqué pour l'installer.
<div class="practical-consequence not-prose">
<p class="practical-consequence__kicker">La règle d'or</p>
<p class="practical-consequence__body">Ne colle jamais une clé dans un espace public : session ChatGPT partagée, Discord, forum, ticket support. Là, elle sort vraiment en clair chez un tiers.</p>
</div>
## 8. Synchronisation du coffre
Quand tu synchronises ton coffre avec Obsidian Sync, GitHub ou autre :
<div class="diagram-cards not-prose">
<div class="diagram-card diagram-card--green"><p class="eyebrow">Recommandé</p><p class="diagram-card-title">Obsidian Sync</p><p class="diagram-card-body">Tes données passent par les serveurs d'Obsidian, mais sont chiffrées de bout en bout avec ton mot de passe d'encryption. Même Obsidian ne peut pas les lire.</p></div>
<div class="diagram-card diagram-card--blue"><p class="eyebrow">Repo online</p><p class="diagram-card-title">GitHub</p><p class="diagram-card-body">Stockage sur serveurs Microsoft (US, soumis au Cloud Act). GitHub ne lit pas le contenu pour entraîner Copilot tant que tu ne l'actives pas explicitement.</p></div>
<div class="diagram-card diagram-card--violet"><p class="eyebrow">Auto-hébergé</p><p class="diagram-card-title">GitLab ou Gitea</p><p class="diagram-card-body">Alternative souveraine dans le cadre d'une option d'installation de son propre serveur.</p></div>
</div>
## 9. Récapitulatif
| Question | Réponse |
|---|---|
| L'IA peut-elle tout faire par défaut sur mon ordi ? | Non. Elle demande validation au cas par cas. Tu peux activer l'auto-accept dans les réglages. |
| Mes fichiers quittent-ils mon ordi en bloc ? | Non. L'IA ne lit que les fichiers pertinents pour ta requête, puis envoie ces extraits seulement. |
| Faut-il un deuxième coffre pour séparer les informations sensibles? | Non. Tu peux changer de modèle selon la tâche dans le même coffre. |
| Comment avoir 0 conservation chez le provider ? | Utiliser les LLM en ZDR (via OpenRouter ou Synthetic AI). |
| Et chez ChatGPT ? | Désactive l'entraînement dans Data Controls. À utiliser uniquement avec des données non sensibles. |
| Existe-t-il des alternatives européennes ? | Oui : Scaleway et OVHcloud sont les meilleures pures options souveraines. |
| Pour des données ultra sensibles ? | Modèle local (Mac Studio Full Spec, Ollama / LM Studio). |
| Où stocker mes API keys ? | Dans un coffre chiffré (1Password), transmis au processus qui en a besoin ; jamais en clair dans un repo public ni un chat public. |
Sécurité, confidentialité et secrets
Dans un cadre professionnel, utiliser l’IA peut impliquer des données soumises au RGPD, à l’AI Act ou à des engagements de confidentialité.
Notre point de départ est un environnement que nous maîtrisons : les fichiers restent en local ou sur nos propres serveurs.
C’est un avantage important, mais certaines données peuvent encore être transmises aux modèles ou aux outils connectés. Ce cours t’aide à repérer ces flux et à choisir les protections adaptées à tes usages professionnels.
Travailler avec l’IA dans tes fichiers locaux, ça soulève deux questions : qu’est-ce qu’elle peut faire sur ton ordinateur, et qu’est-ce qui sort vers le provider quand tu lui parles. Cette leçon répond aux deux, dans cet ordre.
01 / ACTIONS
Ce que l’IA peut faire.
Les permissions définissent son périmètre d’action sur ton ordinateur.
C’est le premier point à comprendre. Quand tu lances OpenCode Desktop, l’IA ne peut rien faire sans ta validation. Elle a la configuration de base d’OpenCode, qui te demande explicitement avant chaque action :
Lire ce fichier : tu valides ?
Modifier cette note : tu valides ?
Exécuter cette commande bash : tu valides ?
C’est volontaire. Tu gardes le contrôle de tout, mais ça peut vite devenir lourd au quotidien.
Mode strict
Validation au cas par cas
L'IA demande la permission avant chaque action. Maximum de sécurité, friction quotidienne forte.
Mode équilibré
Permissions ciblées
Tu autorises les actions sûres (lecture, écriture dans ton coffre), tu bloques les risquées (rm, curl). Équilibre fluide.
Mode auto
Auto-accept tout
L'IA peut tout faire sans demander. Fluide pour le travail intensif, à éviter sur projets clients sensibles.
Le bouton « accepter automatiquement »
Dans les réglages d’OpenCode Desktop, tu peux activer une option qui dit à l’IA : « tu peux faire ce que tu veux sans me demander, je te fais confiance ». Pratique quand tu travailles à fond. Tu peux la désactiver à tout moment.
Compromis classique : confiance maximale (fluide mais l’IA peut tout faire) vs validation au cas par cas (sécurisé mais lent). La plupart des participants finissent par activer l’auto-accept dans leur coffre, et désactivent quand ils travaillent sur des projets clients sensibles.
Restreindre finement les permissions
Si tu veux quelque chose entre les deux extrêmes (auto-accept ou validation totale), tu peux configurer précisément ce que l’IA peut faire dans le fichier opencode.json à la racine de ton workspace.
Le mini-prompt pour configurer tes permissions sans toucher au JSON
Plutôt que d’apprendre la syntaxe opencode.json, copie-colle ce prompt à ton IA dans OpenCode :
Prompt à coller dans OpenCode
Je veux configurer tes permissions dans opencode.json.
D'abord, lis la documentation officielle ici :
https://opencode.ai/docs/permissions
Ensuite, pose-moi ces questions une par une, attends ma réponse
(oui / non / précise) avant de passer à la suivante :
1. Tu peux lire les fichiers dans Business Brain/ sans me demander ?
2. Tu peux écrire dans Business Brain/ sans me demander ?
3. Tu peux accéder aux autres dossiers de mon Workspace ?
4. Tu peux exécuter des commandes shell (git, ls, cat) sans me demander ?
Ce sont des instructions données à l'ordinateur via le terminal :
par exemple, lister des fichiers, lire leur contenu ou gérer l'historique
des modifications. Certaines commandes git peuvent aussi modifier
des fichiers ou envoyer des données en ligne.
5. Tu peux exécuter des commandes réseau (curl, wget) sans me demander ?
Elles permettent de contacter des sites ou des services en ligne,
de télécharger des fichiers ou d'envoyer des données hors de ton ordinateur.
6. Tu peux exécuter des commandes destructrices (rm, mv, rmdir) sans me demander ?
Elles permettent de supprimer des fichiers ou des dossiers, ou de les
déplacer et renommer. Un déplacement peut aussi remplacer un fichier
existant ; une suppression peut être définitive, sans passer par la corbeille.
À la fin, mets à jour opencode.json avec mes choix, montre-moi le résultat,
et explique-moi en une phrase ce que ça change.
L’IA va lire la doc à jour, te poser les questions dans ton langage, et écrire le JSON pour toi. Tu valides à la fin. Tu n’as jamais à toucher au JSON manuellement.
2. Ce qui est envoyé au modèle (et ce qui ne l’est pas)
C’est le deuxième point essentiel : quand tu poses une question à ton IA, qu’est-ce qui sort de ton ordinateur exactement ?
La réponse va te rassurer.
Ton coffre n’est pas uploadé en bloc
À chaque requête, l’IA ne « charge » pas tout ton coffre en mémoire pour ensuite l’envoyer au provider. Voici ce qui se passe vraiment :
Sur ton ordinateur
Tout ton coffre reste local
L'IA scanne les noms de fichiers et la structure
Elle identifie les fichiers pertinents pour ta question
Elle lit uniquement ceux-là (3, 5, parfois 20 fichiers)
Elle écrit les modifications directement sur ton disque
Envoyé au provider IA
Uniquement des extraits
Ta question (le prompt)
Le contenu des fichiers que l'IA a lus
L'historique de la conversation en cours
Rien d'autre. Pas de scan global, pas d'upload du coffre
Image mentale : l’IA ouvre 3 onglets de notes dans Obsidian, lit ces 3 notes, et c’est tout ce qui sort. Le reste du coffre reste invisible pour le provider.
Conséquence pratique
Tu n’as pas besoin de deux coffres séparés (un « sécurisé » et un « pas sécurisé »). L’IA ne va lire que ce dont elle a besoin pour la requête en cours.
Et tu peux utiliser différents modèles selon la sensibilité de chaque tâche, dans le même coffre. Par exemple :
Tâche de brainstorm: DeepSeek V4 Flash sur OpenRouter ZDR
Tâche avec données clients : GLM 5.3 via Synthetic AI (abonnement ZDR)
Tâche créative sans enjeu : ChatGPT (GPT 5.6)
Tu bascules dans OpenCode Desktop en une seconde. Le coffre reste le même.
3. Pourquoi la confidentialité, c’est important
Les points clés en 1 minute :
Snowden, 2013 : les agences de renseignement américaines (NSA Prism, programme XKeyscore) ont un accès direct aux serveurs de Google, Facebook, Apple, Microsoft. La devise interne : « on enregistre tout, on filtrera plus tard si besoin ». Le programme existe toujours, en plus puissant.
Cloud Act, 2018 : toute entreprise US (peu importe où sont les serveurs) doit livrer les données au gouvernement américain sur demande. Donc même un data center « européen » d’AWS ou Azure est concerné.
Politiques de rétention en pratique : ChatGPT conserve par défaut tant que ton compte existe. Claude conserve 5 ans + 30 jours après suppression + jusqu’à 2 ans pour modération « trust & safety » humaine. La suppression vraiment effective est rarement immédiate.
Le marché de la prédiction : ton profil comportemental vaut de l’argent. C’est ce que documente Shoshana Zuboff dans The Age of Surveillance Capitalism. Cambridge Analytica, Brexit, élection Trump sont les exemples emblématiques.
La posture saine
Considérer que tout ce qui sort vers un provider US est potentiellement archivé pour toujours, peu importe ce que dit leur politique de confidentialité officielle.
Qu’est-ce qui est en jeu pour ton entreprise ?
Un document professionnel traité par une IA engage rarement ton seul périmètre. Il peut contenir des informations sur ton entreprise, tes clients, tes collaborateurs ou tes partenaires. La confidentialité couvre alors l’ensemble de ces enjeux : la conformité réglementaire, la protection de tes secrets d’affaires et de ta stratégie, le respect de tes engagements contractuels, et ta capacité à démontrer la sécurisation et l’usage des données de tiers.
1. Tes secrets d’affaires et ton avantage concurrentiel
Tes marges, tes méthodes internes, ton fichier clients, ton code source ou ta stratégie de développement peuvent représenter des années de travail. Certaines de ces informations ont de la valeur précisément parce que tes concurrents n’y ont pas accès.
Exemple : tu demandes à une IA de revoir ta stratégie commerciale en lui donnant tes prix d’achat, tes marges et les conditions négociées avec tes fournisseurs. Tu confies alors une partie de ton savoir-faire commercial à un prestataire extérieur.
En Belgique comme en France, la protection des secrets d’affaires repose sur un cadre européen commun. Elle suppose notamment de prendre des mesures raisonnables pour préserver leur confidentialité. Le choix des outils d’IA et les conditions dans lesquelles tu leur transmets des données font partie de cette réflexion. (SPF Économie)
2. Les engagements pris envers tes clients et partenaires
Un client peut t’autoriser à consulter ses documents pour réaliser une mission, sans t’autoriser à les transmettre à n’importe quel service externe.
Exemple : tu reçois le business plan confidentiel d’un client et tu le donnes à une IA pour préparer une synthèse. Selon l’accord de confidentialité ou le contrat de prestation, cette transmission peut nécessiter une autorisation ou des garanties particulières.
Le sujet n’est donc pas seulement : « Est-ce que mes données vont fuiter ? » Il est aussi : « Est-ce que mes engagements me permettent de les confier à ce fournisseur ? » Le SPF Économie identifie d’ailleurs les accords de confidentialité avec les partenaires commerciaux comme une mesure de protection des secrets d’affaires. (SPF Économie)
3. Les données personnelles de tes collaborateurs et de tes clients
Un CV, une fiche de paie, une évaluation annuelle ou un historique de réclamations contient des informations sur des personnes. Leur traitement par une IA reste soumis au RGPD, applicable à travers toute l’Europe.
Exemple : tu demandes à une IA de comparer plusieurs candidats en lui transmettant leurs CV et tes notes d’entretien. Tu fais traiter des données personnelles par un service supplémentaire.
Il faut notamment définir l’usage, limiter les données transmises au nécessaire et vérifier les conditions de traitement du fournisseur. Désactiver l’entraînement sur tes données ne suffit pas, à lui seul, à rendre cet usage conforme. L’Autorité de protection des données belge rappelle que les utilisateurs et exploitants de systèmes d’IA doivent respecter les principes de protection des données personnelles. (APD belge)
4. Tes dossiers juridiques et ta stratégie de défense
Un projet de contrat, un dossier de litige ou des échanges avec ton avocat peuvent contenir des informations particulièrement confidentielles.
Exemple : tu demandes à une IA de t’aider à préparer une négociation en lui transmettant les faiblesses de ton dossier et le montant maximal que tu accepterais de payer. Ces informations révèlent directement ta stratégie.
Selon la nature des documents, la profession concernée et le droit applicable, des obligations de confidentialité ou de secret professionnel peuvent s’ajouter. Il faut donc vérifier avec le conseil concerné quels documents peuvent être utilisés et dans quel environnement.
5. Tes négociations et tes projets stratégiques
Certaines informations sont sensibles parce qu’elles arrivent au mauvais moment entre les mauvaises mains : projet d’acquisition, levée de fonds, réponse à un appel d’offres, lancement d’un produit ou négociation fournisseur.
Exemple : tu demandes à une IA de préparer une offre à partir d’un document qui contient ton prix plancher, ton budget maximal et les concessions possibles. Si ces informations deviennent accessibles à l’autre partie, ta position de négociation peut être affaiblie.
Le risque à maîtriser est celui d’une divulgation ou d’un accès non prévu. Il n’est pas nécessaire de supposer qu’un fournisseur revendrait volontairement tes informations pour justifier leur protection.
6. La protection des données de tiers et la preuve de conformité
Quand tu traites des données pour le compte d’une organisation — client, partenaire ou donneur d’ordre — tu deviens responsable de leur usage et de leur sécurisation. Le RGPD ne demande pas seulement de respecter ces obligations : il demande de pouvoir le démontrer.
Exemple : un client te demande où sont traitées les données de ses clients, combien de temps elles sont conservées et qui peut y accéder. Sans documentation, tu ne peux pas répondre.
Pour chaque outil d’IA utilisé sur des données de tiers, tu dois pouvoir préciser : quelles données sont transmises, à quel prestataire, pour quelle finalité, combien de temps elles sont conservées, qui peut y accéder et selon quelles garanties contractuelles (accord de sous-traitance, clauses de confidentialité, localisation du traitement). Cette traçabilité relève directement du principe de responsabilité du RGPD. (APD belge)
La posture à adopter
Avant de transmettre un document à une IA, pose-toi trois questions :
Qu’est-ce que ce document révèle ? Des informations publiques, des données personnelles, du savoir-faire ou une stratégie confidentielle ?
Ai-je le droit de le partager avec ce prestataire ? Au regard de mes contrats, de mes obligations et des règles de mon entreprise.
Quelles garanties couvrent réellement cet usage ? Accès, conservation, réutilisation, sous-traitants et localisation du traitement.
L’objectif est de choisir le bon outil et le bon niveau de protection pour chaque tâche, afin de profiter de l’IA tout en protégeant ton entreprise.
4. La confidentialité au quotidien : deux options ZDR
C’est la recommandation par défaut pour 90 % des cas.
ZDR (Zero Data Retention) signifie que ta requête arrive au provider, le modèle génère une réponse, et tout est supprimé immédiatement. Rien stocké, rien loggué, rien réutilisé pour entraîner un modèle. Le provider s’engage contractuellement et c’est auditable.
Pour ton usage professionnel, tu as deux options ZDR complémentaires. On met en avant Synthetic AI (abonnement professionnel) pour tout ce qui touche des données clients ou sensibles, et on garde OpenRouter ZDR (au token) pour un usage non intensif ou un large choix de modèles.
Option 1 (à privilégier pour le professionnel) : Synthetic AI
Synthetic AI est un abonnement à 30 $/mois (pas de paiement au token) qui te donne des tokens ZDR (zéro rétention), servis très rapidement. C’est notre recommandation pour tout ce qui est sensible : données clients, raisonnement sur des sujets sensibles, tâches complexes. Tu prends l’abonnement, tu le connectes dans OpenCode, et tout passe en ZDR sans jamais réfléchir au coût par requête.
OpenRouter permet d’accéder à l’ensemble des LLM en ZDR et de facturer au token. C’est parfait pour une utilisation non intensive de l’IA et pour avoir accès à un maximum de LLM.
openrouter.ai : 400+ modèles, 60+ providers, une seule API.
Connecte-toi sur openrouter.ai(pas besoin de le faire maintenant : cette étape est couverte dans la partie « Installer ton Core System »)
Va dans Settings (en haut à droite)
Section Privacy : active Zero Data Retention
Save
OpenRouter ne route alors que vers des providers qui ont signé l’engagement ZDR (Fireworks, Parasail, certaines instances DeepInfra…). Tes requêtes ne sont plus stockées.
Routes ZDR
Synthetic AI / OpenRouter
Entraînement sur tes données : non
Stockage de tes conversations : non
Accès humain à tes échanges : non
Idéal pour : usage non intensif, large choix de modèles
À éviter pour le sensible
Abonnements ChatGPT Plus et Claude Pro
Entraînement : oui par défaut, opt-out manuel
Stockage : tant que le compte existe
Accès humain : possible (modération abus)
Rétention minimum : 30 jours après suppression
Sur ChatGPT, désactive l’entraînement
Si tu utilises ChatGPT Plus connecté à OpenCode Desktop, fais ce réglage manuellement :
Va sur chatgpt.com, clique sur ton avatar en haut à droite (pas besoin de le faire maintenant : cette étape est couverte dans la partie « Installer ton Core System »)
Settings, puis Data Controls
Désactive « Improve the model for everyone »
OpenAI ne peut plus utiliser tes conversations pour entraîner ses modèles. Note : la rétention reste tant que ton compte existe, ce n’est pas du ZDR. Pour les tâches sensibles, préfère Synthetic AI (GLM 5.3) ou OpenRouter ZDR.
5. Si tu préfères héberger en Europe
Pour ceux qui veulent une infrastructure non-US par principe (souveraineté, RGPD strict, Cloud Act), voici les options réelles à l’été 2026.
Recommandation : Scaleway Generative APIs
Scaleway est la meilleure option européenne pure-play. Data centers en France, ZDR par défaut (pas besoin d’activer une option), pas d’entraînement sur tes données, RGPD natif. Ils proposent Llama 3, Mistral, Mixtral, DeepSeek R1. Pas dépendant d’AWS / Azure / GCP : infrastructure propre.
Alternative équivalente : OVHcloud AI Endpoints
OVHcloud AI Endpoints, data centers à Gravelines, plus de 40 modèles open source, certifié ISO 27001/27017/27018/27701. Souveraineté française complète, infrastructure 100 % propre.
6. Pour les données très sensibles : faire tourner le modèle en local
Si tu travailles avec des données de santé, juridiques, hautement confidentielles, ou si tu veux la souveraineté absolue, fais tourner le modèle sur ton propre matériel. Rien ne sort de ton réseau.
La règle de base : pour que ça soit utilisable, le modèle doit tenir entièrement dans ta RAM (sur Mac, c’est de la RAM unifiée partagée avec le GPU). S’il déborde sur le disque, la vitesse s’effondre. Ton plafond de RAM détermine donc directement les modèles auxquels tu as accès.
Le plus simple (CLI)
Ollama
Une commande pour tout installer (curl -fsSL ollama.com/install.sh | sh), puis ollama run qwen3:8b. Idéal pour OpenCode Desktop qui s'y connecte en un clic.
Une app desktop avec catalogue de modèles, téléchargement en un clic, chat intégré, et un serveur local compatible OpenAI. Plus accessible si tu fuis le terminal.
Tier 1 : 16 Go de RAM (MacBook Air M2, MacBook Pro M3 base)
16 Go · Découvrir le local · Modèles de 3 à 8B
Tu peux faire tourner des modèles de 3 à 8 milliards de paramètres en Q4 (quantisation 4 bits). C’est suffisant pour du chat, de l’aide à la rédaction, des recherches simples. Pas suffisant pour de l’agentique avancé (multi-step, tool calls complexes).
Modèles à essayer :
Gemma 4 E2B (Google, ~3,5 Go en Q4). C’est le nouveau modèle Google sorti en avril 2026. Multimodal (texte + audio + image). DeepMind a annoncé en mai un projet « Accelerating Gemma 4 » qui ajoute du multi-token prediction (le modèle prédit plusieurs tokens à la fois, ce qui accélère l’inférence sans dégrader la qualité). À surveiller.
Qwen 3 4B ou Qwen 3 8B : très bon rapport qualité/taille, contexte 256K.
Llama 3.2 3B : rapide, qualité correcte pour du chat.
Vitesse attendue : 30 à 60 tokens/seconde sur Mac M3 16 Go. Confortable pour du chat, juste pour de l’agentique.
L’intérêt à ce tier, c’est surtout de comprendre comment le local fonctionne et de tester. Pour un usage knowledge worker complet, tu seras vite limité.
Tier 2 : 32 à 64 Go de RAM (MacBook Pro M3 Max, Mac mini M4 Pro)
32–64 Go · Travailler au quotidien · Modèles de 12 à 32B
C’est le tier où le local devient vraiment utilisable au quotidien. Les modèles 12 à 32 milliards de paramètres deviennent confortables.
Gemma 4 26B-A4B (Google, MoE, ~18 Go en Q4) : 3,8B de paramètres actifs seulement à chaque token, donc rapide.
Qwen 3 32B (Q4) : meilleur open weight 30B à l’été 2026.
DeepSeek R1 32B (Q4) : fort en raisonnement.
Mistral Small 24B (Q4) : inférence très rapide.
Sur 64 Go, les modèles 70B (~43 Go en Q4) deviennent accessibles : Llama 3.3 70B, DeepSeek R1 70B.
Tier 3 : 128 Go et plus (Mac Studio M3/M4 Ultra)
128 Go et + · Grands modèles · Infrastructure dédiée
C’est ici que tu peux faire tourner les gros modèles open source frontières (GLM 5.3, DeepSeek V4 Flash, Qwen 3 235B). Ordre de prix :
Mac Studio M3 Ultra 192 Go : 10 000 à 13 000 €
Mac Studio M4 Ultra 512 Go : 25 000 à 30 000 € (haut de gamme grand public absolu)
À 192 Go, tu peux faire tourner :
DeepSeek R1 70B en Q8 (~80 Go) : qualité quasi équivalente à la version full precision
Qwen 3 235B MoE en Q2 (~90-100 Go) : 22B actifs à chaque token
GLM 5.3 744B MoE en Q2 (~150 Go estimé) : 40B actifs
Mistral Large 123B en Q4 (~75 Go)
À 512 Go, DeepSeek V4 Flash en Q4 ou même certains modèles 400B+ deviennent faisables.
Comprendre la quantisation (Q2, Q4, Q5…)
Un modèle « brut » stocke ses paramètres en 16 bits (FP16). Le quantiser, c’est compresser ces paramètres sur moins de bits, pour qu’il prenne moins de RAM.
Niveau
Bits/poids
Effet sur la qualité
Quand l’utiliser
Q5
~5 bits
Quasi identique au full precision
Si tu as la RAM
Q4
~4 bits
Légère perte, peu perceptible
Le défaut recommandé
Q2
~2 bits
Dégradation visible : hallucinations, raisonnement moins fiable
Uniquement pour les très gros modèles (100B+) quand tu n’as pas le choix pour tenir en RAM
Le suffixe K_M ou K_S (K-quant Medium / Small) indique une variante optimisée qui préserve mieux les couches importantes du modèle. Pour Ollama, le défaut est généralement Q4_K_M, c’est très bien.
Pour aller plus loin
Sur le hardware et l’optimisation du local, je te recommande la chaîne YouTube @xcreate qui couvre le sujet en profondeur : choix de hardware, quantisation, comparaisons de modèles, retours d’expérience sur les Mac Studio.
Cas pratique : une équipe qui mutualise
Pour une société de 5 à 50 personnes, un Mac Studio Full Spec partagé devient rapidement rentable comparé à 10 ou 50 abonnements API. Tu installes Ollama dessus, tu exposes l’API en réseau local, chacun connecte son OpenCode Desktop dessus. Rien ne sort de l’infra. ROI typique : moins d’un an de mutualisation par rapport aux abonnements individuels.
7. Gérer ses secrets : API keys et mots de passe
La meilleure solution est d’utiliser un gestionnaire de mots de passe. Il centralise proprement tous tes secrets (clés API, mots de passe, tokens, clés SSH) et permet à ton IA de récupérer un secret à la volée dans tes scripts ou tes sessions, sans jamais l’exposer en local. Ton coffre reste protégé dans un environnement dédié.
Si tu étends ton intégration IA à tes équipes, il permet aussi de mutualiser certains accès et clés API, tout en gardant le niveau de contrôle requis.
Si tu en utilises déjà un, nous pourrons analyser sa compatibilité et l’intégrer dans ta stack. Si ce n’est pas encore le cas, nous préconisons 1Password.
Pourquoi 1Password ?
1Password conserve cette clé dans un coffre chiffré. Son Environment la transmet uniquement au processus qui en a besoin. La configuration OpenCode contient la commande et l’identifiant de l’Environment, jamais la valeur de la clé.
Ne colle jamais une clé dans un espace public : session ChatGPT partagée, Discord, forum, ticket support. Là, elle sort vraiment en clair chez un tiers.
8. Synchronisation du coffre
Quand tu synchronises ton coffre avec Obsidian Sync, GitHub ou autre :
Recommandé
Obsidian Sync
Tes données passent par les serveurs d'Obsidian, mais sont chiffrées de bout en bout avec ton mot de passe d'encryption. Même Obsidian ne peut pas les lire.
Repo online
GitHub
Stockage sur serveurs Microsoft (US, soumis au Cloud Act). GitHub ne lit pas le contenu pour entraîner Copilot tant que tu ne l'actives pas explicitement.
Auto-hébergé
GitLab ou Gitea
Alternative souveraine dans le cadre d'une option d'installation de son propre serveur.
9. Récapitulatif
Question
Réponse
L’IA peut-elle tout faire par défaut sur mon ordi ?
Non. Elle demande validation au cas par cas. Tu peux activer l’auto-accept dans les réglages.
Mes fichiers quittent-ils mon ordi en bloc ?
Non. L’IA ne lit que les fichiers pertinents pour ta requête, puis envoie ces extraits seulement.
Faut-il un deuxième coffre pour séparer les informations sensibles?
Non. Tu peux changer de modèle selon la tâche dans le même coffre.
Comment avoir 0 conservation chez le provider ?
Utiliser les LLM en ZDR (via OpenRouter ou Synthetic AI).
Et chez ChatGPT ?
Désactive l’entraînement dans Data Controls. À utiliser uniquement avec des données non sensibles.
Existe-t-il des alternatives européennes ?
Oui : Scaleway et OVHcloud sont les meilleures pures options souveraines.
Pour des données ultra sensibles ?
Modèle local (Mac Studio Full Spec, Ollama / LM Studio).
Où stocker mes API keys ?
Dans un coffre chiffré (1Password), transmis au processus qui en a besoin ; jamais en clair dans un repo public ni un chat public.